Mixture of Experts 基礎技術メモ
はじめに
最近のオープンウェイトLLMを見渡すと、DeepSeek-V4.1-Flash(552B)、Kimi K3(2.8T)、MiMo-V2.6(1T)など、トップクラスのモデルのほぼすべてがMixture of Experts(以下、MoE)を採用している。本記事ではMoEに関する基礎的な技術をメモしていく。
本記事の内容はStanfordの授業、論文、テクニカルレポートなどを参考にしている。また、Transformerの基本的な構造や、Self-AttentionやFeed Forward Network(以下、FFN)については、ここでは触れない。Transformerの基礎を理解していることを前提に話を進める。
MoEの直感的な説明とよくある誤解
MoEのよくある直感的な説明はこんな感じだ。
- 通常のTransformerはどんなタスクが来ても、すべてのニューラルネットワークを使って対応する。学校で例えるなら、数学の問題なのに、英語教師・理科教師・数学教師・体育教師などで総出で当たるようなイメージだ。これはあまり効率的ではない。
- そこで、MoEでは「これは数学担当のエキスパート、英語担当のエキスパート、理科担当のエキスパート、…」というようにやりたいことに応じてエキスパートを使い分ける。各エキスパートがそれぞれの強い分野を処理することで、より良い出力を得る。
しかし、実際にはそんなに簡単ではない。そもそもエキスパートがそんなに綺麗に分かれているわけではない。むしろMoEとは、sparseに活性化されるサブコンポーネントを持つモデルアーキテクチャである。現在主流のLLMでは、トークンごとに活性化されるエキスパートは異なる。
MoEへのモチベーション
なぜMoEがここまで使われているのか?
MoEのモチベーションは、「パラメータを増やせばモデルは賢くなる。ただし計算コストはこれ以上払いたくない」という要求にある。昨今のLLMは兆を超えるパラメータを保持するものもあり、莫大な計算コストを要する。MoEをアーキテクチャに組み込めば、計算コストを抑えつつもパラメータ数を増やせる。
MoEのアーキテクチャ概要
MoEによって何が変わったかを理解するためには、Transformerブロックを思い出すと良い。Transformerブロックには主にSelf-AttentionとFFNがある。FFNは全結合された層であり、非常にdenseである。MoEはこのdenseなFFN層を置き換える1。次の図で見るとわかりやすい。
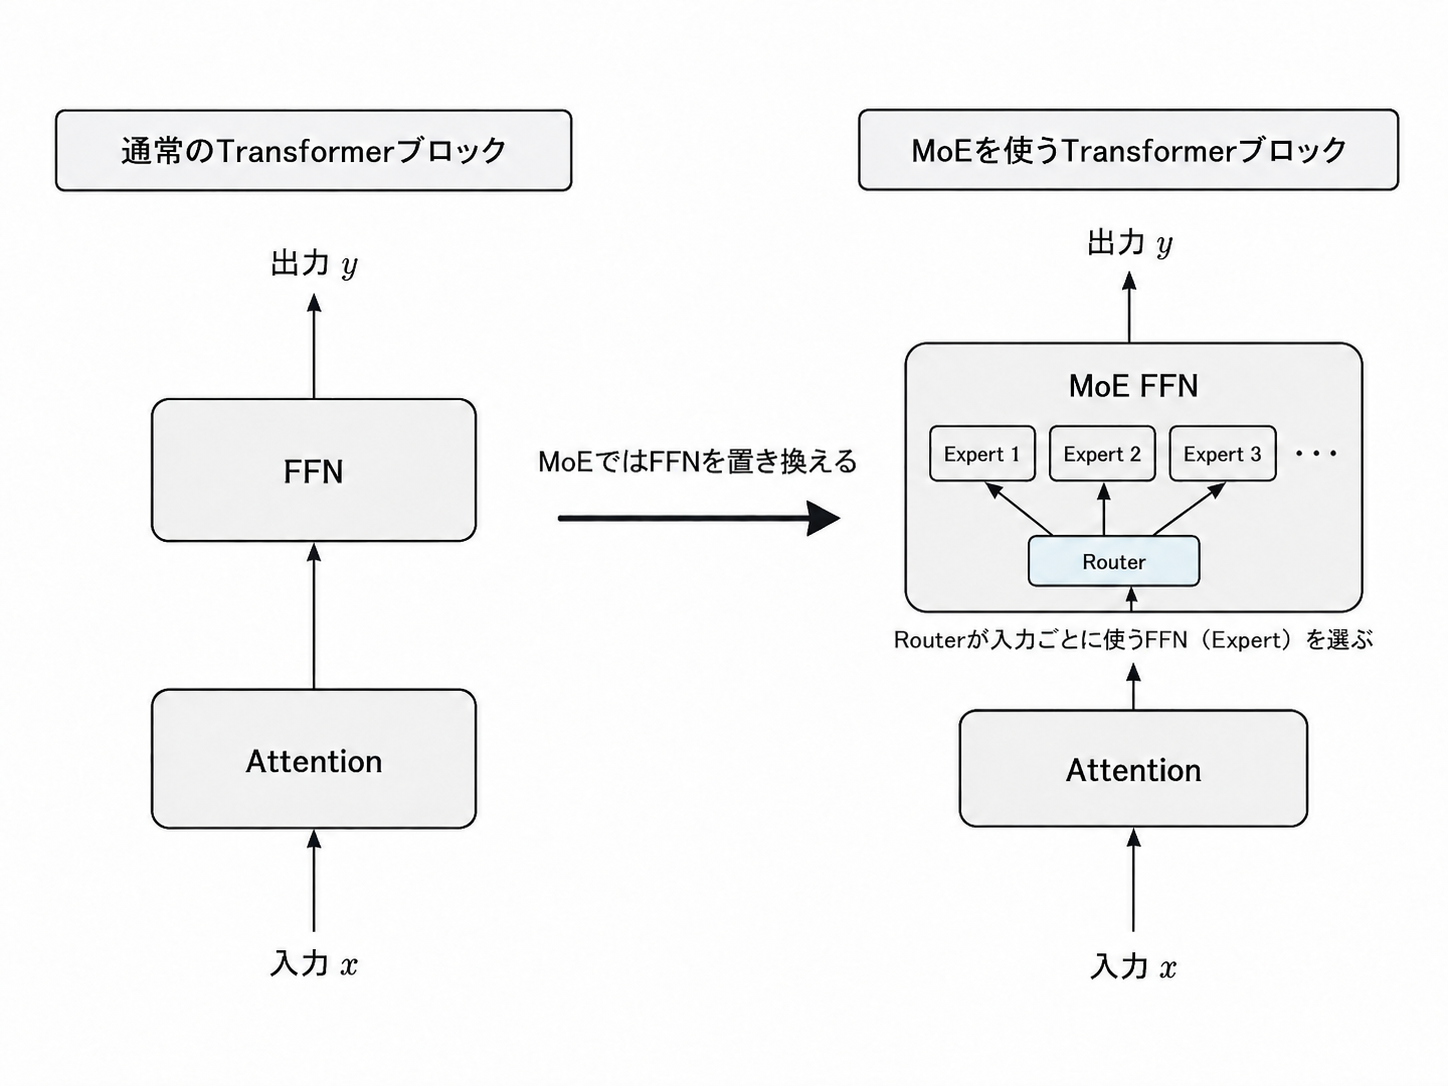
左側はMoE無であり、右側がMoE有の流れだ。(実際には、Expertの出力をマージする箇所や正規化もあるので、この図は大幅に簡略化している)
右側の図からもわかるように、入力はルーターによって振り分けられ、そこで選ばれたエキスパートにルーティングされる。
MoEのルーティング
MoEの難しさの1つはこのルーティングにある。エキスパート自体を増やすのはそんなに難しくないが、ルーティングの性能が酷いと後述する崩壊が起きるのだ。ということで、ルーティングは肝なので、少し詳しく書いていく。
まず、大きな視点から考えると、どのエキスパートを使うかを決める必要がある。設計の選択肢は大きく3つに分かれる。
| 方式 | 選び方 | 特徴 |
|---|---|---|
| Token choice | 各トークンが、自分に合う上位K個のエキスパートを選ぶ | 各トークンにとって最良のエキスパートが選ばれる。負荷は偏ることがある |
| Expert choice | 各エキスパートが、自分に合う上位K個のトークンを選ぶ | 各エキスパートの処理量が完全に均等になりやすく、デバイス利用率が安定しやすい |
| Global assignment | 割当や最適輸送を解いて全体最適な対応付けを求める | うまくいくかもしれないが、計算コストが見合わない |
この中で結果的に主流になっているのがToken choiceだ。
ちなみに、ハッシュしてルーティングするような方法もある。MoEのルーターを学習させる代わりに、入力を単なるハッシュ関数でエキスパートに割り当てる。「なんて適当な」と思われるかもしれないが、なんとこれでも性能が上がると報告されている。(ここから言えるのは、賢いルーティングではなくパラメータ容量を増やせばいいじゃん、という見方もできるかもしれない)
token choiceでのMoEの処理の流れ
MoEの処理の流れは次のとおりだ。
- まず入力されたトークンは、MoEのルーターに渡される
- ルーターが、どのエキスパートにトークンを送り込むか決める(=ルーティング)
- 全エキスパートに対するsoftmaxなどで確率分布を出して、値が大きい上位k個(Top-k)に送り込む
- ここでは、ルーティング用の小さな線形層を準備する(論文により名称は違う。例えばSwitch TransformerであればW_r(Router用のWeight))
- トークンを受け取った各エキスパートは、TransformerのFFNと同様の計算を行う
- エキスパートの出力に対して、ルーターが出した確率を重みとして乗算して、それらの和を取り、残差接続と足し合わせる
ルーティングを賢くする際の注意点
単純なTransformerブロックと異なり、MoEでは、学習時にルーティングの学習という別個の課題が生じる。代表的な課題とその解法を以下でまとめておく。
エキスパート崩壊
トークンはルーターによって各エキスパートに分散される。その分散具合は学習過程で定まっていく。学習開始直後のルーターの重みはランダムなので、偶然どこかのエキスパートにわずかに多くトークンが集まってしまうことがある。そこから先は、正のフィードバックループが回ってしまう。これは図で見るとわかりやすい。
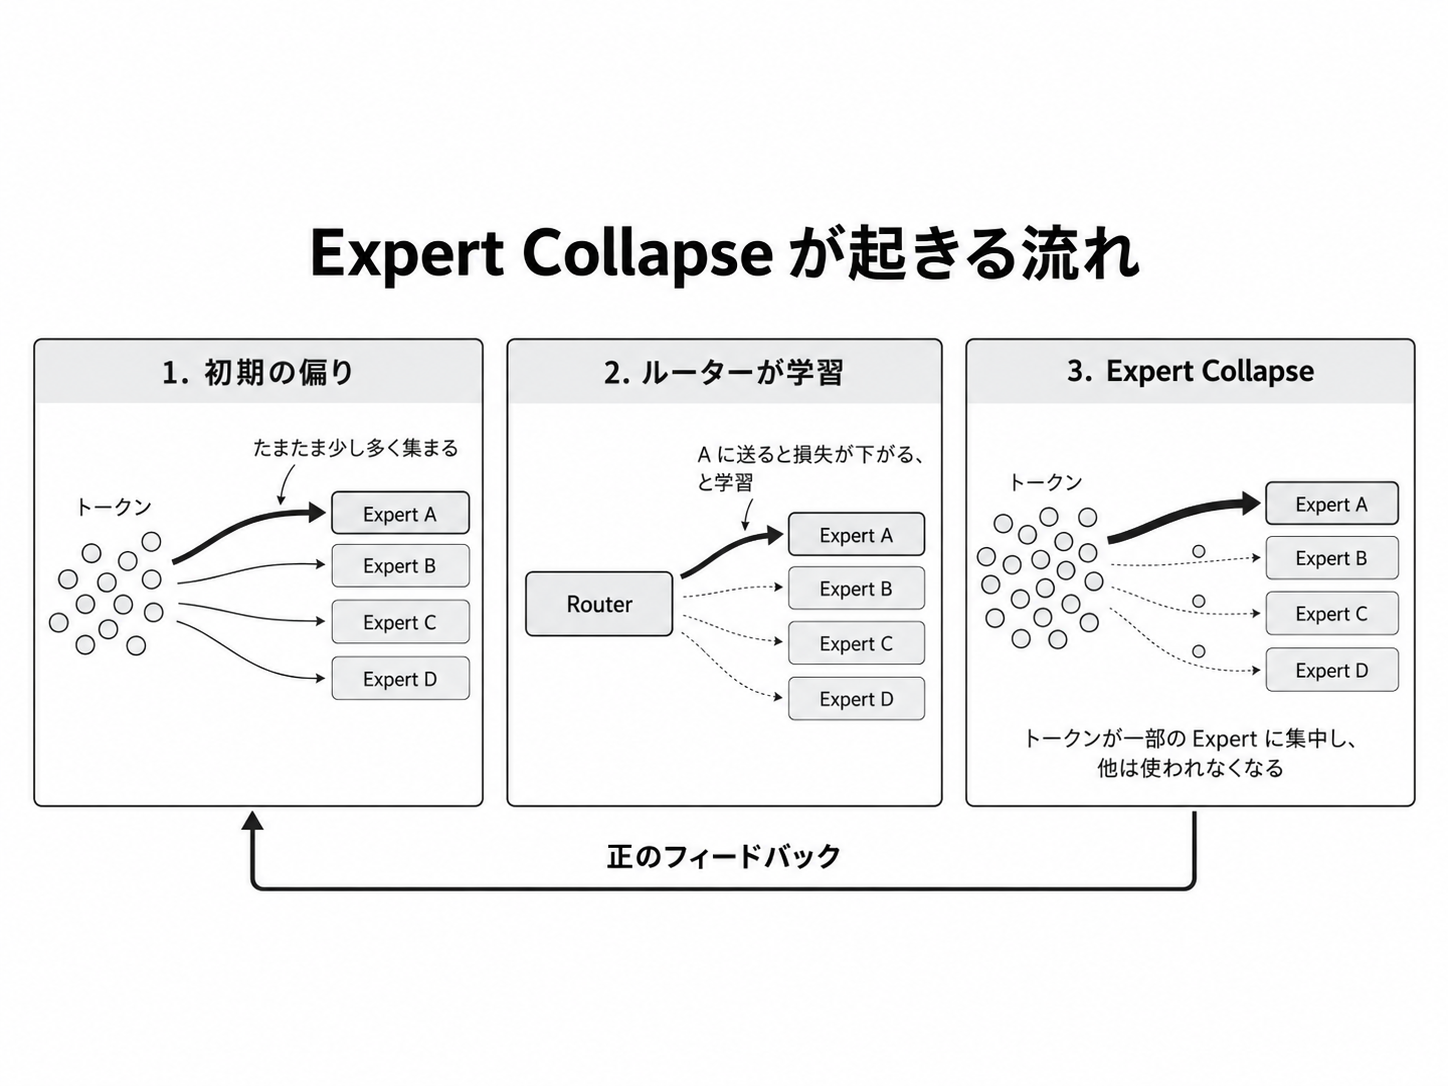
実際にOLMoEのアブレーションにて具体の結果が書いてある。8つのエキスパートからTop-2で選ばせた場合、学習開始直後には1つのエキスパートがほぼすべてのトークンを受け取っている。その後もう1つのエキスパートにもトークンが流れるようになるが、最終的にもほぼこの2つだけでトークンを分け合い、残る6つはほとんど使われない。論文ではこれらをdead weightsと表現している。これがエキスパート崩壊だ。(Loss-Free Balancing (Wang et al., 2024)では、ルーティング崩壊とも呼ばれている)
別のパターンの崩壊としては、エキスパート同士が同じような特徴を学習してしまって、結局性能が出ないみたいなのもある。
補助損失
ここまでで述べた課題を防ぐためには、できるだけ均等にエキスパートを使うようにルーターが振る舞わないといけない。
そのために考案された1つの方式が、補助負荷分散損失(Auxiliary Load Balancing Loss)である。Switch Transformerでも利用されている。この方式は、2つの登場人物を押さえると良い。
- 実際にエキスパートに送られたtokenの割合
- これをfとする
- (あるバッチ全体で)ルーターがエキスパートに割り振ろうとした確率(の平均)
- これをpとする
ここでは、超シンプルな例で簡単に計算してみよう2。仮にエキスパートが2つ、top-kは1、トークンが4つあったとしよう。さらにルーティング用の重みW_rを使って計算した結果、以下の表のスコアになったとする。
| トークン | エキスパート1の確率 | エキスパート2の確率 | Top-1で選ばれるエキスパート |
|---|---|---|---|
| ho | 0.8 | 0.2 | エキスパート1 |
| ge | 0.6 | 0.4 | エキスパート1 |
| fu | 0.9 | 0.1 | エキスパート1 |
| ga | 0.2 | 0.8 | エキスパート2 |
上記の表をもとに、まずfから考える。
- f_エキスパート1
- 3回選ばれているので f_エキスパート1 は 3/4 = 0.75
- f_エキスパート2
- 同様に 1/4 = 0.25
次にpを考える。こちらは表を縦に見て平均を取る。
- p_エキスパート1 = (0.8 + 0.6 + 0.9 + 0.2) / 4 = 0.625
- p_エキスパート2 = (0.2 + 0.4 + 0.1 + 0.8) / 4 = 0.375
あとは、エキスパートごとに得られたものをそれぞれ掛け合わせて、合計を取りエキスパートの数をかける。
(f_エキスパート1 × p_エキスパート1 + f_エキスパート2 × p_エキスパート2) × エキスパートの全数
= (0.75 × 0.625 + 0.25 × 0.375) × 2
= (0.46875 + 0.09375) × 2
= 2 × 0.5625
= 1.125
と、数字が1より大きいことがわかる。面倒だから計算はカットするが、仮に全てのエキスパートに均等に分散している場合はこの数値が1となる。したがって、1より大きいことから偏りがあることがわかる。
また、この数値は、1より大きいほど偏りが大きくなる。(エキスパート数を増やして、適当に数値を入れて計算すればわかる)
ここまでわかれば、当初計算していた「ルーターがエキスパートに割り振ろうとした確率(p)」の算出に使用していたW_rを重みを逆伝播して更新すれば、エキスパートの偏りが是正されていく。
ここまでくると、元の名称にある補助負荷分散損失(Auxiliary Load Balancing Loss)もイメージが湧くかもしれない。言語モデルの主損失に加えて、MoEのルーティングに対して補助的にLossを使って負荷分散(Load balancing)しているので、この名称になっているのだろう。3
補助損失のトレードオフ
ただし、補助損失にはトレードオフが潜んでいる。以下に示す、学習時の目的が干渉してしまうのだ。
- 言語モデル本来の目的は、次のトークンを最も正確に予測したいこと
- 補助損失の目的は、エキスパートを均等に使わせたいこと
精度を上げたい方向と無理に空いているエキスパートへ回したい方向が衝突する。
DeepSeek-V3のアプローチ → Aux-loss-free(バイアス)
ここまでの話を背景にDeepSeek-V3のアプローチを説明する。V4系が出ているのに、なぜV3を紹介するかというと、別のオープンウェイトフロンティアモデルであるMiMo-V2.5/V2.6でも同系統のアプローチが使われている(らしい)ため。
さて前項で説明した目的の干渉を嫌ったDeepSeek-V3は、負荷分散の補助損失ではないアプローチを採用した。
代わりに動的なバイアスを使うようにした。ここでのバイアスとは、学習中に状況に応じて値が変わる一種の補正値と思ってもらえれば良い。
具体例で考えてみよう。例えばルータが、あるトークンに対する4つのエキスパートのスコアを次のように出したとする。
| エキスパート | 元のスコア |
|---|---|
| 1 | 0.90 |
| 2 | 0.70 |
| 3 | 0.50 |
| 4 | 0.30 |
通常なら上位のエキスパート1、Top-2であれば2つ目のエキスパート2も選ばれる。しかしDeepSeek-V3では、ここに負荷分散用のバイアスを加える。
| エキスパート | 元のスコア | バイアス | 選択用スコア |
|---|---|---|---|
| 1 | 0.90 | -0.25 | 0.65 |
| 2 | 0.70 | 0.00 | 0.70 |
| 3 | 0.50 | +0.25 | 0.75 |
| 4 | 0.30 | +0.10 | 0.40 |
この場合、エキスパート1は混雑しているためバイアスが下げられ、逆に空いているエキスパート3は選ばれやすくなる。
ポイントは、このバイアスはエキスパートを選ぶ時だけ使うことだ。実際に選ばれたエキスパートの出力をどの割合で混ぜるかについては、選ばれたエキスパートの元スコアを正規化して使う。
そして学習中は、各エキスパートに実際に何トークン流れたかを確認し、
- 混みすぎているエキスパート → バイアスを下げる
- 空いているエキスパート → バイアスを上げる
という調整を繰り返す。
これがDeepSeek-V3のAux-loss-freeの中心的なアイデアである。
なお、名前はAux-loss-freeだが、厳密には補助損失を完全にゼロにしているわけではない。主な負荷分散をバイアスに任せつつ、極端な偏りを防ぐための小さな補助損失は併用している。
Kimi K3 → Quantile Balancing
DeepSeek-V3の動的バイアスは、256個のエキスパートを持つMoEでうまく機能した。しかし、Kimi K3のように「896個のエキスパートから16個を選ぶ」という極端にスパースなMoEになると、バイアスの更新方法そのものが問題になってくる。
DeepSeek-V3では、各エキスパートの負荷を見ながら、一定の調整幅でバイアスを少しずつ上下させる。
しかし、この方法にはトレードオフがある。
- 調整幅を小さくすると、負荷の偏りを直すまでに多くの更新ステップが必要になる
- 逆に調整幅を大きくすると、今度は補正しすぎて、エキスパートへの割り当てが激しく上下する
- 他に厄介なのは、同じだけバイアスを動かしても、エキスパートによって負荷の変化量が違うこと
- Top-16の境界付近に多くのトークンが集まっているエキスパートは、少しバイアスを上げるだけで大量のトークンが流れ込む
- 一方、境界付近にほとんどトークンがいないエキスパートでは、同じだけ動かしても負荷がほとんど変わらない
そこでKimi K3が導入したのが、Quantile Balancingである。
Quantileとは耳慣れない言葉かもしれないが、ヒストグラムをイメージしてもらうと良い。Quantileは和訳だと、分位点を意味する。統計の授業で習った四分位数を思い出してほしい。
Quantile Balancingの発想は、バイアスをどちら向きに少し動かすかを繰り返すのではなく、各エキスパートについて、どのくらいバイアスを動かせば、目標数のトークンがTop-16に入るのかを分布から直接求めてしまうというものだ。ちょっとわかりにくいので、以下の図を見てもらうと良い。「あぁ、この位置(分位点/Quantile)が知りたいのか」と直感的にわかると思う。
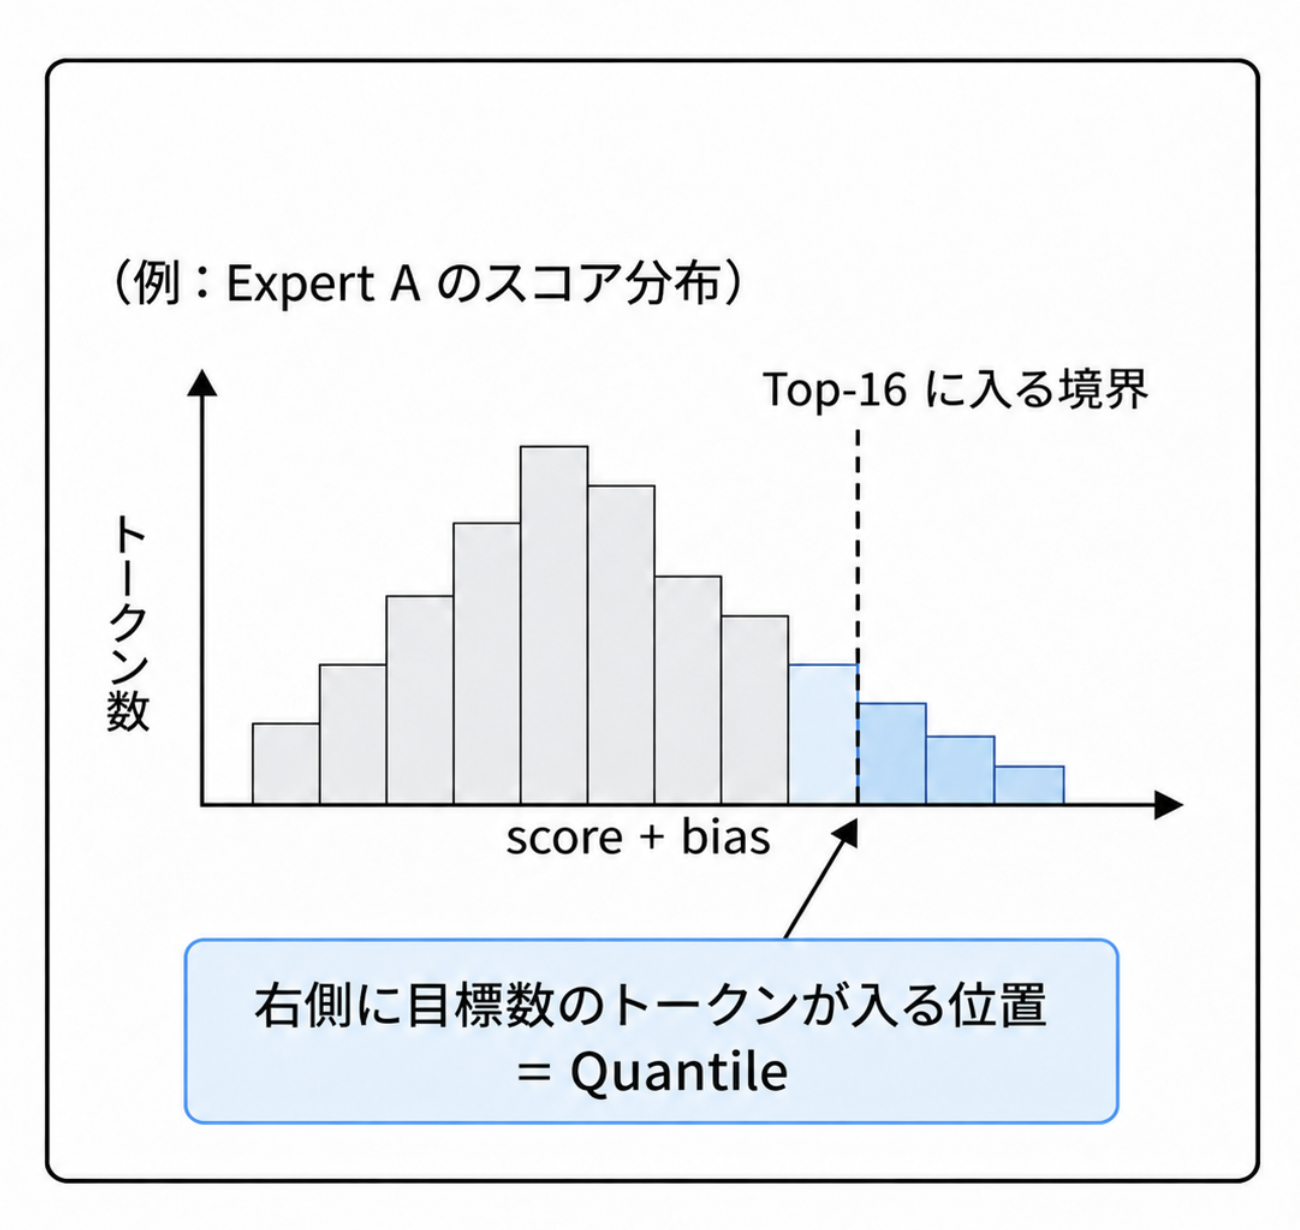
上記のような分布を利用して、Top-16の値がわかれば、次のステップで使うバイアスに必要な調整幅を求められる。分位点を使っているので、これがQuantile Balancingという名前の由来(だと思う)。
これなら、固定の調整幅を細かくチューニングする必要がなく、896個のように多数のエキスパートを持つ極端にスパースなMoEでも、負荷分散を素早く安定させやすい。
MiMo-V2.6
先日リリースされたばかりのMiMo-V2.6も当然MoEである。MiMo-V2.6もMiMo-V2.5から続いて、DeepSeek系のAux-loss-freeと同様に、エキスパートごとの補正バイアスを選択時だけ加える仕組みのようだ。(V2.6のテクニカルレポートでは、この部分に特化した記載がないのでやや推測)
なお、MiMo-V2.6は強化学習(RL)を主軸としているわけだが、RLするとルーティングが偏ってしまって崩壊が起きてしまったとテクニカルレポートで書かれている。切り分けとして、RL後にルーティングのパラメータだけ切り戻したところ、負荷の偏りが元通りになったらしい。
その他
MoE関連のトピックはたくさんあるのだが、全然書き終わらないので、知っておくとよさそうなトピックをあと少しだけ書いて終わりにする。
必要なGPUメモリって?
これは私がMoEを学んだ際に最初に思った疑問で、MoEを実際に動かそうとする際にどれだけGPUメモリが必要なのかということ。活性化されたパラメータ数は少ないなら、もしかしてGPUの調達コストを減らせる?と思ったのだけど、全然甘くなかった。
つまり、総パラメータを載せられるだけのGPUメモリが必要となる。したがって、市販のGPUなどで動かそうとする場合は、量子化などの技術併用が必須となる。(量子化については、佐藤先生の『深層ニューラルネットワークの高速化』がとても詳しい)
共有エキスパート(Shared Experts)
公開されているフロンティアなMoE設計でよく使われるのが共有エキスパートである。
どんな文脈でも必要となる共通な処理がある。これを各エキスパートが個別に学習して保持するのは無駄なので、ルーティング云々に関わらず、必ず全トークンが経由する共有エキスパートを置くアプローチだ。DeepSeek-V3とV4.1-Flashは1個、Kimi K3は2個を採用している。
ただし、以下のように主張が割れているので、今後変わるかもしれない。
- DeepSeekのアブレーションでは明確な改善が出ている
- 一方、OLMoEの比較では共有エキスパートの有無で有意な差が出ず、最終的に採用が見送られている
- また、MiMo-V2.6 でも、共有エキスパートは使われていない
マルチモーダルだと?
(DeepSeek-V4.1のマルチモーダルな補正バイアスの話などがあるけど、1万字弱を書いて疲れたのでまた今度…)
おわりに
かなり長くなってしまったが、MoEで知っておくとよさそうな基礎的な技術と、最近のモデルでの取り組みをいくつか紹介した。この辺の内容がわかっていると、各社が出しているテクニカルレポートやモデルカードが読みやすくなると思う。
次は、Sliding Window Attention と Global Attention あたりを書くかもしれないし、書かないかもしれない。あるいは、書きかけているエンジニアリングマネジメントの記事続きを書くかもしれない。